

从对其他客户的过去回复中学习
ReplyRabbit 可以将每份草稿与您的团队已经发送给其他客户的回复进行核对,并补充草稿中缺失的事实。在 ReplyRabbit 设置下的知识来源、从过往回复中学习,按邮箱开启此功能。它默认关闭,处于 Beta 阶段,需要 Pro 或 Team 计划。
它做什么
草稿照常根据对话和您的知识源编写。然后 ReplyRabbit 查找其他客户之前提出的与新消息相似的问题,并阅读您团队发送的答案。如果其中一个答案包含您的文档和草稿中没有的有用事实,草稿会更新以包含它。如果没有新内容,草稿保持原样。
- 它只添加事实。语气、问候语和结构保持草稿原样。
- 另一位客户对话中的个人详细信息在存储任何内容之前会被掩码,更新后的草稿会再次检查这些信息。
- 它最多可为一份草稿增加两次简短的 AI 调用,因此会多消耗一点你的 AI 额度。
- 您手动请求的草稿不会被检查,除非您勾选“也检查手动草稿”,因为检查可能会增加几秒钟的等待时间。
匹配基于关键词。使用 Semantic Search 插件已安装并建立索引后,它还会按含义匹配,因此措辞不同的问题仍能找到正确答案。未安装插件时,关键词匹配可单独工作。
开始之前
- 一个 Pro 或 Team 套餐。在 Free 套餐中会显示该开关,但无法开启。
- 一个 FreeScout 管理员账户。其他用户可以看到该设置,但无法更改。
- FreeScout 后台队列正在运行,ReplyRabbit 已经需要它来处理草稿。
- 一些历史记录:邮箱需要你的团队在过去 3 到 12 个月内发送的回复。
开启它

打开“对其他客户的回答”
打开邮箱,然后打开 ReplyRabbit 设置。在顶部的状态面板中,选择“其他客户的答案”。它会带您进入知识来源卡片。开启从过往回复中学习
在知识来源卡片中找到从过去的回复中学习并开启它。选择回溯多远
选择最近 3、6 或 12 个月。默认是 12。保存您的设置
学习按钮仅在开关保存后起作用。检查有多少
选择检查有多少。它会统计可以使用的回复,并告诉您有多少将被跳过以及原因。这不使用 AI。开始学习
选择开始学习并确认。
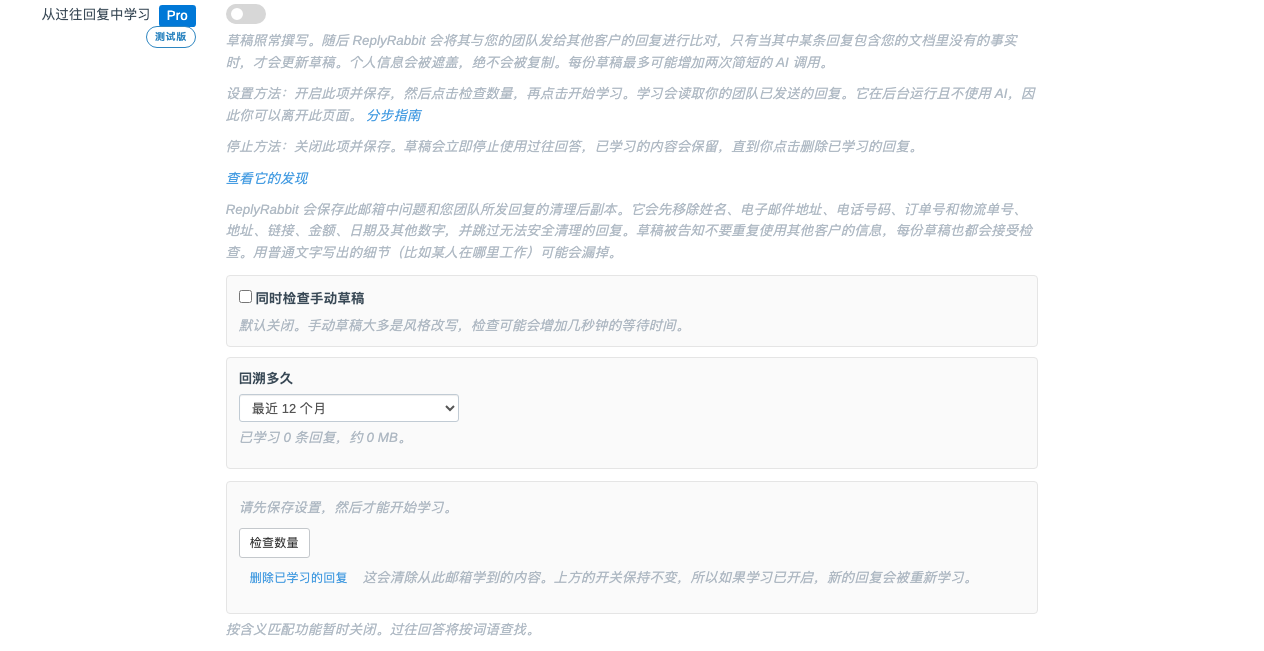
学习意味着读取你团队已发送的回复,清除个人详细信息,并存储每个问题及其答案。它在后台运行且不使用 AI,因此你可以离开页面。进度行显示已查看、已学习和已跳过的回复数量。你可以暂停、恢复或取消它。一旦答案被学习,新草稿会与它们进行核对,并且随着你团队发送新回复,新回复会被添加。
查看它发现了什么
在开关下方,See what it's found 会打开 Past replies 活动页面。它显示检查了多少草稿、有多少有匹配的回复、有多少有新事实、有多少被更改,以及使用的额外令牌。管理员还可以打开一行来比较第一份草稿与更新后的草稿。该文本保留 30 天。
在你开启后的前六周内,大约五分之一的带有新事实的草稿会被故意保持不变。这为活动页面提供了两组进行比较,以便你可以看到更新是否有帮助。
关闭它或重新开始
- 要停止,请关闭 Learn from past replies 并保存。草稿会立即停止使用过去的答案。已学习的内容会被保留,因此你可以稍后重新开启。
- 要移除已学习的内容,请选择 Delete learned answers。此操作无法撤销。如果开关仍开启,新回复在发送时会再次被学习。
- 要保留更少,请在 How far back to look 下选择更短的期限并保存。较旧的条目会在后台移除。
存储了什么
ReplyRabbit 为每个不同的回复保留一条记录:问题、你的团队发送的答案以及时间。姓名、电子邮件地址、电话号码、订单和跟踪号、地址、链接、金额、日期和其他数字在存储任何内容之前都会被替换为占位符。多次发送的回复只存储一次。
- 仅保留最近 3、6 或 12 个月的数据。
- 每个邮箱最多保存 5,000 个条目。超过后,保留最新的。
- 无法安全清理的回复会被跳过,估算会将它们与原因一起计入。
- 归档到垃圾邮件、永久删除或属于你已删除的客户的对话会立即移除。移动到已删除文件夹的对话将在下一次每日清理时移除。
一切都存储在你自己的 FreeScout 数据库中。当检查草稿时,只有几个匹配答案的掩码文本会发送给你的 AI 提供商。
什么永远不会延续
仅从过往答案中提取通用事实,例如产品行为方式或哪个设置可解决问题。如果某个事实看起来与另一客户相关,则会被丢弃:姓名、数字、日期、金额、价格、代码、地址或链接。起草更新后,ReplyRabbit 会检查其中是否包含过往答案中的细节,若发现则保留第一版起草。
用简单文字写成的细节,例如某人在哪里工作,并不总能被识别出来,因此请将这些检查视为保障措施,并在发送前阅读草稿,就像您已经做的那样。
语言和限制
此首个版本为英语构建。其他语言的客户消息按其包含的词语进行匹配,并且英语之外的姓名掩码较弱:常见名字和大城市在德语答案中会被掩码,但不太常见的名字或小城镇可能会保留,因此在依赖它之前请检查德语邮箱。不使用词间空格的语言(如中文、日文或泰文)按短字符序列而非词语进行匹配。在非常大的邮箱上,这种搜索较慢且不如英语精确,并且用这些文字书写的姓名仅在后面跟随标题或问候语时才会被掩码,因此在依赖它之前请检查这些邮箱。
掩码基于大小写以及您自己的回复和文档中使用的词语。它可能会漏掉完全用小写书写的人名或公司名,以及被改写而非直接命名的个人细节,例如对某人工作的描述。看起来包含此类细节的答案会被跳过而不是存储。
相关
参见 ReplyRabbit 如何从您过去的对话中学习 了解草稿使用的其他来源。查看 选择 AI 提供方 以了解你邮箱的提供商数据路径。