

他の顧客への過去の返信から学ぶ
ReplyRabbitは、各下書きをチームが他の顧客にすでに送信した回答と照合し、下書きに欠けていた事実を追加できます。ReplyRabbit設定の「Knowledge sources」にある「Learn from past replies」でメールボックスごとに有効にできます。デフォルトではオフで、Beta版であり、ProまたはTeamプランが必要です。
それが行うこと
下書きは通常どおり、会話とナレッジソースから作成されます。その後、ReplyRabbitは新しいメッセージに似た他の顧客からの以前の質問を探し、チームが送信した回答を読みます。それらの回答の1つに、ドキュメントと下書きにない有用な事実が含まれている場合、下書きはそれを含むように更新されます。新しいものがない場合、下書きはまったく変更されません。
- 事実のみを追加します。トーン、挨拶、構成は下書きのまま維持されます。
- 他の顧客の会話からの個人情報は、何かが保存される前にマスクされ、更新された下書きで再度チェックされます。
- 下書きに最大2回の短いAI呼び出しを追加するため、AI許容量を少し多く消費します。
- 手動で依頼した下書きは、「手動下書きもチェック」にチェックを入れない限りチェックされません。チェックにより数秒の待ち時間が追加されるためです。
マッチングはキーワードで機能します。 Semantic Search プラグインがインストールされインデックスが作成されると、意味によるマッチングも行うため、表現が異なる質問でも適切な回答が見つかります。プラグインがない場合は、キーワードマッチングのみが機能します。
始める前に
- ProまたはTeamプラン。Freeではスイッチは表示されますが、オンにできません。
- FreeScoutの管理者アカウント。他のユーザーは設定を表示できますが、変更はできません。
- FreeScout バックグラウンドキューが実行中であること。ReplyRabbit は下書きにすでにこれを必要とします。
- 履歴について: メールボックスには、過去3~12か月にチームが送信した返信が必要です。
オンにする

他の顧客への回答を開く
メールボックスを開き、次にReplyRabbit設定を開きます。上部のステータスパネルで「Answers to other customers」を選択します。ナレッジソースカードに移動します。過去の返信から学習を有効にする
Knowledge sourcesカードでLearn from past repliesを見つけてオンにします。どこまで遡るかを選択
過去3、6、または12か月を選択します。デフォルトは12です。設定を保存
学習ボタンは、スイッチが保存された後にのみ機能します。どれくらいあるか確認する
「Check how much there is」を選択します。使用できる返信をカウントし、スキップされる数とその理由を通知します。AIは使用しません。学習を開始
「Start learning」を選択して確認します。
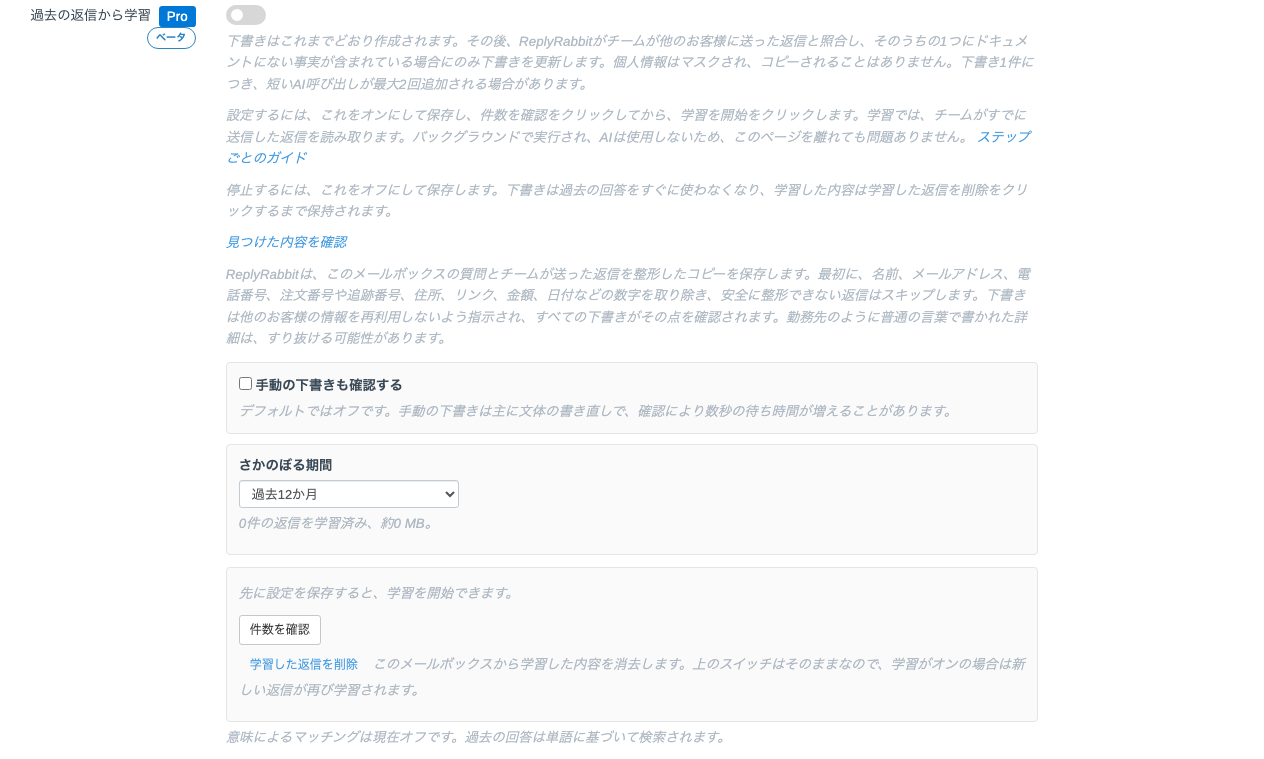
学習とは、チームが送信した返信を読み、個人情報を除去し、各質問をその回答とともに保存することを意味します。バックグラウンドで実行され、AIを使用しないため、ページを離れることができます。進行状況ラインには、確認、学習、スキップされた返信の数が表示されます。一時停止、再開、キャンセルが可能です。回答が学習されると、新しい下書きがそれらに対してチェックされ、チームが送信するにつれて新しい返信が追加されます。
見つかった内容を見る
スイッチの下で、「見つけたものを見る」をクリックすると過去の返信アクティビティページが開きます。チェックされた下書きの数、一致する返信があった数、新しい事実があった数、変更された数、および使用された追加トークンが表示されます。管理者は行を開いて最初の下書きと更新された下書きを比較することもできます。そのテキストは30日間保持されます。
有効化後の最初の6週間、新しい事実を含む下書きの約5件に1件は意図的に変更されません。これによりアクティビティページに比較用の2つのグループができ、更新が役立つかどうかを確認できます。
オフにするか、やり直す
- 停止するには、「過去の返信から学習」をオフにして保存します。下書きはすぐに過去の回答を使用しなくなります。学習した内容は保持されるため、後で再びオンにできます。
- 学習した内容を削除するには、「学習した回答を削除」を選択します。これは元に戻せません。スイッチがまだオンの場合、新しい返信は送信時に再び学習されます。
- 保持を減らすには、「どこまで遡るか」でより短い期間を選択して保存します。古いエントリはバックグラウンドで削除されます。
保存されるもの
ReplyRabbitは個別の返信ごとに1つのエントリを保持します: 質問、チームが送信した回答、およびその時期です。名前、メールアドレス、電話番号、注文番号と追跡番号、住所、リンク、金額、日付、その他の数値は、保存前にプレースホルダーに置き換えられます。何度も送信された返信は1回だけ保存されます。
- 直近 3、6、12 か月分のみが保持されます。
- 各メールボックスは最大5,000エントリを保持します。それを超えると、最新のものが保持されます。
- 安全にクリーンアップできない返信はスキップされ、見積もりはそれらを理由とともにカウントします。
- スパムに分類された会話、完全に削除された会話、または消去した顧客に属する会話はすぐに削除されます。削除済みフォルダに移動された会話は、次回の日次クリーンアップで削除されます。
すべてはお客様自身のFreeScoutデータベースに保存されます。下書きがチェックされるとき、一致するいくつかの回答のマスクされたテキストのみがAIプロバイダーに送信されます。
引き継がれないもの
過去の回答からは一般的な事実のみが取得されます (製品の動作や問題を解決する設定など)。事実が他の顧客に結びついていると思われる場合 (名前、番号、日付、金額、価格、コード、住所、リンク) は除外されます。下書きが更新された後、ReplyRabbit は過去の回答からの詳細がないか確認し、見つかった場合は最初の下書きを保持します。
勤務先などの平易な言葉で書かれた詳細は常に見つけられるとは限らないため、これらのチェックは安全策として扱い、これまで通り送信前に下書きを読んでください。
言語と制限
この最初のリリースは英語向けに構築されています。他の言語の顧客メッセージは含まれる単語で照合され、名前のマスキングは英語以外では弱くなります。ドイツ語の回答では一般的なファーストネームと大都市はマスクされますが、あまり一般的でない名前や小さな町は残る可能性があるため、依存する前にドイツ語のメールボックスを確認してください。中国語、日本語、タイ語など単語間にスペースを書かない言語は、単語ではなく短い文字の連続で照合されます。その検索は非常に大きなメールボックスでは遅く、英語よりも精度が低く、これらのスクリプトで書かれた名前は敬称や挨拶が後に続く場合にのみマスクされるため、依存する前にこれらのメールボックスを確認してください。
マスキングは大文字表記と、あなた自身の返信やドキュメントで使用されている単語から機能します。完全に小文字で書かれた人物や会社、および誰かの仕事の説明など、名前ではなく言い換えられた個人の詳細を見逃す可能性があります。この種の詳細を含むと思われる回答は、保存されずにスキップされます。
関連
参照 ReplyRabbitが過去の会話から学習する方法 下書きが使用する他のソースについて。確認: AIプロバイダーの選択 メールボックスのプロバイダーデータパスを理解します。