

Leer van eerdere antwoorden aan andere klanten
ReplyRabbit kan elk concept controleren tegen antwoorden die je team al naar andere klanten heeft gestuurd, en een ontbrekend feit toevoegen. Schakel dit per mailbox in onder ReplyRabbit-instellingen, Kennisbronnen, Leren van eerdere antwoorden. Het staat standaard uit, het is in Beta en het vereist een Pro- of Team-abonnement.
Wat het doet
Het concept wordt zoals gebruikelijk geschreven, op basis van het gesprek en je kennisbronnen. Daarna zoekt ReplyRabbit naar eerdere vragen van andere klanten die lijken op het nieuwe bericht en leest de antwoorden die je team heeft gestuurd. Als een van die antwoorden een nuttig feit bevat dat je documentatie en het concept niet hebben, wordt het concept bijgewerkt om het op te nemen. Als er niets nieuws is, blijft het concept precies zoals het was.
- Het voegt alleen feiten toe. Toon, begroeting en structuur blijven zoals opgesteld.
- Persoonlijke gegevens uit het gesprek van de andere klant worden gemaskeerd voordat er iets wordt opgeslagen, en het bijgewerkte concept wordt er opnieuw op gecontroleerd.
- Het kan tot twee korte AI-aanroepen toevoegen aan een concept, dus het gebruikt iets meer van je AI-tegoed.
- Concepten die u handmatig aanvraagt, worden niet gecontroleerd tenzij u Ook handmatige concepten controleren aanvinkt, omdat de controle een paar seconden wachttijd kan toevoegen.
Matchen werkt op basis van trefwoorden. Met de Semantic Search plugin geïnstalleerd en geïndexeerd, dan matcht het ook op betekenis, zodat een anders geformuleerde vraag nog steeds het juiste antwoord vindt. Zonder de plugin werkt keyword-matching op zichzelf.
Voordat je begint
- Een Pro- of Team-abonnement. Op Free wordt de schakelaar getoond maar kan niet worden ingeschakeld.
- Een FreeScout-beheerdersaccount. Andere gebruikers kunnen de instelling zien maar niet wijzigen.
- De FreeScout-achtergrondwachtrij actief, die ReplyRabbit al nodig heeft voor concepten.
- Enige historie: de mailbox heeft antwoorden nodig die je team in de afgelopen 3 tot 12 maanden heeft verzonden.
Zet het aan

Antwoorden aan andere klanten openen
Open de mailbox en vervolgens ReplyRabbit-instellingen. Selecteer in het statuspaneel bovenaan Antwoorden aan andere klanten. Je komt bij de kaart Kennisbronnen.Leren van eerdere antwoorden inschakelen
Zoek Learn from past replies in de Knowledge sources-kaart en schakel het in.Kies hoe ver terug te kijken
Kies de laatste 3, 6 of 12 maanden. 12 is de standaard.Sla je instellingen op
De leerknoppen werken pas nadat de schakelaar is opgeslagen.Controleer hoeveel er is
Selecteer Controleer hoeveel er is. Het telt de antwoorden die het kan gebruiken en vertelt je hoeveel er worden overgeslagen en waarom. Dit gebruikt geen AI.Begin met leren
Selecteer Start met leren en bevestig.
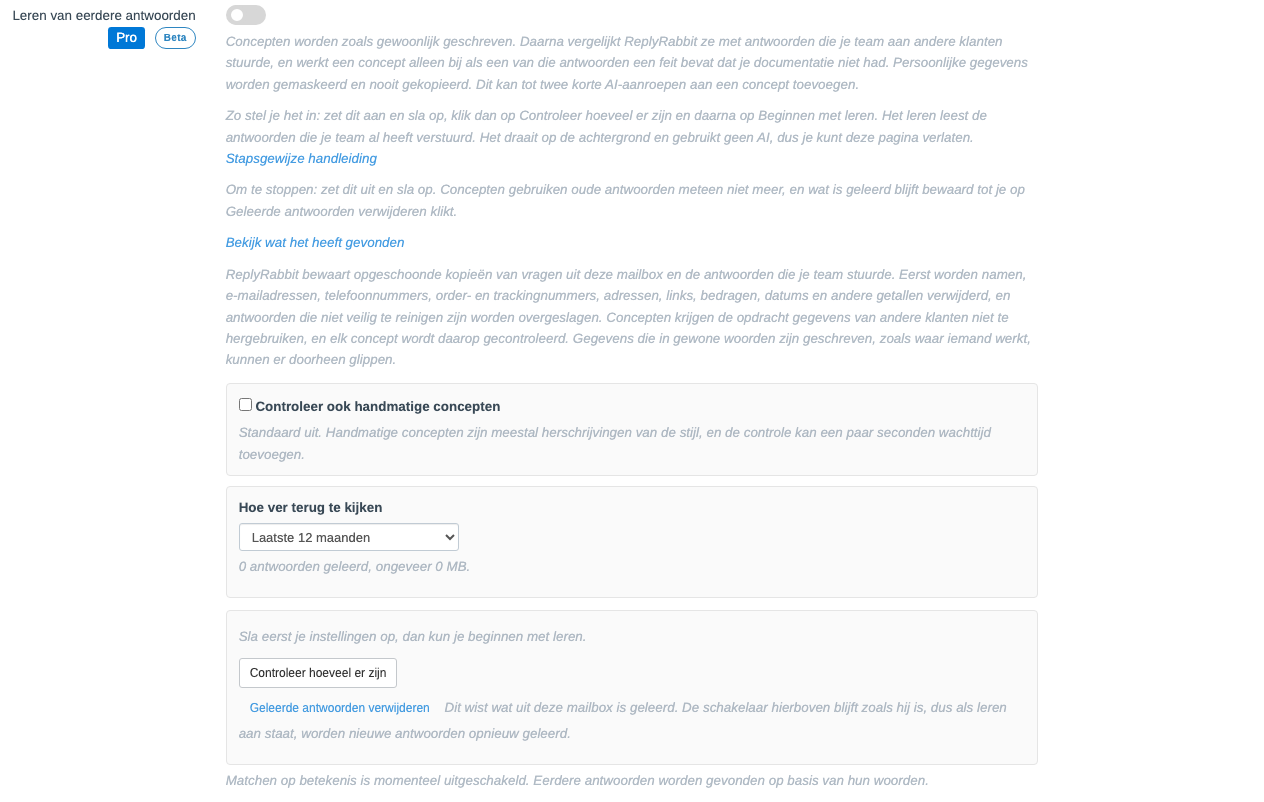
Leren betekent de verzonden antwoorden van je team lezen, persoonlijke gegevens eruit filteren en elke vraag met het bijbehorende antwoord opslaan. Het draait op de achtergrond en gebruikt geen AI, dus je kunt de pagina verlaten. Een voortgangsregel toont hoeveel antwoorden zijn bekeken, geleerd en overgeslagen. Je kunt het pauzeren, hervatten of annuleren. Zodra antwoorden zijn geleerd, worden nieuwe concepten ertegen gecontroleerd en worden nieuwe antwoorden toegevoegd zodra je team ze verzendt.
Bekijk wat het heeft gevonden
Onder de schakelaar opent Bekijk wat het heeft gevonden de activiteitenpagina Eerdere antwoorden. Deze toont hoeveel concepten zijn gecontroleerd, hoeveel een overeenkomend antwoord hadden, hoeveel een nieuw feit hadden en hoeveel zijn gewijzigd, samen met de extra gebruikte tokens. Beheerders kunnen ook een rij openen om het eerste concept met het bijgewerkte te vergelijken. Die tekst wordt 30 dagen bewaard.
In de eerste zes weken nadat je het inschakelt, blijft ongeveer één op de vijf concepten met een nieuw feit bewust ongewijzigd. Zo heeft de activiteitenpagina twee groepen om te vergelijken, zodat je kunt zien of de updates helpen.
Zet het uit of begin opnieuw
- Om te stoppen, zet je Leren van eerdere antwoorden uit en sla je op. Concepten gebruiken direct geen eerdere antwoorden meer. Wat is geleerd blijft bewaard, zodat je het later weer kunt aanzetten.
- Om te verwijderen wat is geleerd, selecteer je Geleerde antwoorden verwijderen. Dit kan niet ongedaan worden gemaakt. Als de schakelaar nog aan staat, worden nieuwe antwoorden opnieuw geleerd wanneer ze worden verzonden.
- Om minder te bewaren, kies je een kortere periode onder Hoe ver terug te kijken en sla je op. Oudere vermeldingen worden op de achtergrond verwijderd.
Wat wordt opgeslagen
ReplyRabbit bewaart één vermelding per afzonderlijk antwoord: de vraag, het antwoord dat je team heeft gestuurd en wanneer. Namen, e-mailadressen, telefoonnummers, order- en trackingnummers, adressen, links, bedragen, datums en andere nummers worden vervangen door placeholders voordat er iets wordt opgeslagen. Een antwoord dat vaak wordt verstuurd, wordt één keer opgeslagen.
- Alleen de laatste 3, 6 of 12 maanden worden bewaard.
- Elke mailbox bevat maximaal 5.000 vermeldingen. Daarna worden de nieuwste behouden.
- Antwoorden die niet veilig kunnen worden opgeschoond, worden overgeslagen, en de schatting telt ze mee samen met de redenen.
- Gesprekken die als spam zijn gemarkeerd, permanent zijn verwijderd of toebehoren aan een klant die je hebt gewist, worden direct verwijderd. Gesprekken die naar de map Verwijderd zijn verplaatst, worden bij de volgende dagelijkse opschoning verwijderd.
Alles wordt opgeslagen in je eigen FreeScout-database. Alleen de gemaskeerde tekst van een paar overeenkomende antwoorden wordt naar je AI-provider gestuurd wanneer een concept wordt gecontroleerd.
Wat nooit wordt overgedragen
Alleen algemene feiten worden overgenomen uit een eerder antwoord, zoals hoe een product zich gedraagt of welke instelling een probleem oplost. Een feit wordt weggelaten als het aan de andere klant gekoppeld lijkt: een naam, nummer, datum, bedrag, prijs, code, adres of link. Nadat een concept is bijgewerkt, controleert ReplyRabbit het op details uit de eerdere antwoorden, en als het er een vindt, behoudt het het eerste concept.
Details in gewone woorden, zoals waar iemand werkt, kunnen niet altijd worden opgemerkt, dus behandel deze controles als vangnetten en lees concepten voordat u ze verzendt, zoals u al doet.
Taal en limieten
Deze eerste release is gebouwd voor Engels. Klantberichten in andere talen worden gematcht op de woorden die ze bevatten, en de masking van namen is zwakker buiten het Engels: veelvoorkomende voornamen en grote steden worden gemaskeerd in Duitse antwoorden, maar een minder voorkomende naam of een klein dorp kan overleven, dus controleer Duitse mailboxen voordat je erop vertrouwt. Talen die zonder spaties tussen woorden worden geschreven, zoals Chinees, Japans of Thai, worden gematcht op korte reeksen tekens in plaats van woorden. Die zoekopdracht is langzamer op zeer grote mailboxen en minder precies dan voor Engels, en namen in deze schriften worden alleen gemaskeerd wanneer een titel of begroeting erop volgt, dus controleer deze mailboxen voordat je erop vertrouwt.
Maskering werkt op basis van hoofdlettergebruik en van woorden die je eigen antwoorden en documentatie gebruiken. Het kan een persoon of bedrijf missen die volledig in kleine letters is geschreven, en een persoonlijk detail dat is geparafraseerd in plaats van genoemd, zoals een beschrijving van iemands baan. Antwoorden waarvan het lijkt dat ze dit soort details bevatten, worden overgeslagen in plaats van opgeslagen.
Gerelateerd
Bekijk Hoe ReplyRabbit leert van je eerdere gesprekken voor de andere bronnen die een concept gebruikt. Controleer Een AI-provider kiezen om het gegevenspad van de provider voor je mailbox te begrijpen.